成本 · 计费
会话越拉越长,龙虾的 API 账单是从哪一条请求开始变贵的
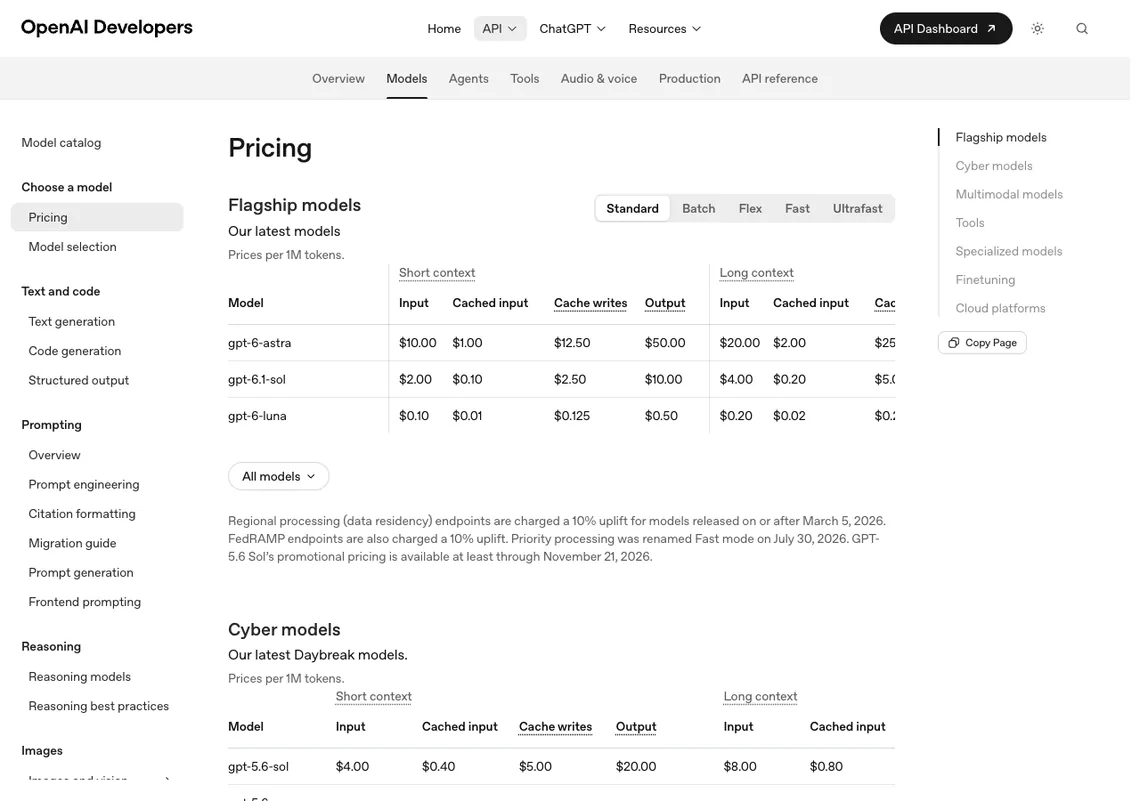
账单在某一天高出一截,先查两条计费规则。一条是长上下文加价:单条请求的输入 token 超过厂商定的门槛,就换用一套更高的单价,OpenAI 的 GPT-6 Astra 门槛是 272K,Gemini 3 Pro 预览版是 20 万。另一条出在提示缓存上:没命中缓存的输入按全价计,缓存写入本身也收费,Anthropic 的 5 分钟缓存写入是输入价的 1.25 倍,1 小时缓存写入是 2 倍。
确认自己踩没踩到,在龙虾的聊天里发 /status,看上下文用量;再发 /usage tokens,之后每条回复末尾会带上这一轮的 token 数和缓存读写数。上下文用量贴近或超过门槛,对的是第一条,命中缓存的部分也算在门槛里,别只盯输入那一个数;cacheWrite 连着几轮都很高、cacheRead 很低,对的是第二条。直连 OpenAI 时 cacheWrite 可能一直是 0,那就只看 cacheRead。
下面的单价取自三家官方定价页,把用量换成你在 /status 里看到的就能重算。
输入超过多少 token 开始加价,OpenAI、Anthropic、Gemini 各是什么规则
表里的单价都是 2026 年 10 月 7 日三家官方定价页上的数字,单位是美元 / 每 100 万 token。每家只列一款,其它型号的价格在各自的定价页上。
| 厂商与型号 | 长上下文门槛 | 过门槛后的输入 / 输出价 | 缓存读取价 | 缓存写入 |
|---|---|---|---|---|
| OpenAI · GPT-6 Astra | 输入超过 272K token | 输入 $10 变 $20,输出 $50 变 $75,整条请求都按新价 | $1.00,过门槛 $2.00 | 收费,$12.50,过门槛 $25.00 |
| Anthropic · Claude Sonnet 5.5 | 没有,1M 窗口内按标准价 | 不变,输入 $2、输出 $10 | $0.20 | 收费,5 分钟缓存 $2.50,1 小时缓存 $4 |
Google · Gemini 3 Pro 预览版(型号 ID gemini-3.1-pro-preview) | 提示超过 20 万 token | 输入 2.00 变 4.00,输出 12.00 变 18.00 | 0.20,过门槛 0.40 | 定价页没有单列写入价,另收存储费 4.50 美元 / 每 100 万 token / 每小时 |
OpenAI 的规则写在 GPT-6 Astra 的模型页上:输入超过 272K token 的提示,整条请求按 2 倍的输入与缓存费率、1.5 倍的输出费率计价。定价页把这两套价排成 Short context 和 Long context 两组。便宜的型号同样有第二组价:gpt-6.1-sol 的输入 / 输出从 $2 / $10 变成 $4 / $15,gpt-6-luna 从 $0.10 / $0.50 变成 $0.20 / $0.75,这两款的模型页写的也是输入超过 272K。Astra 接到龙虾上的其它注意事项在《GPT-6 Astra 给龙虾当大脑》里。
Claude 这边没有第二档。Anthropic 定价页的 Long context pricing 一节说,Claude 4.6 及之后的型号,完整的 1M 上下文窗口都按标准价计,括号里举的例子是 90 万 token 的请求和 9,000 token 的请求每 token 单价相同。用 Claude 的会话变贵,原因要到用量和缓存里找。同一页还有一条和账单有关的备注:Claude 4.7 及之后的型号用了新的分词器,同样的文本大约多出 30% 的 token,具体多少看内容。从更早的型号换过来之后账单变高的,把这一条算进去。
Gemini 的定价页上,按提示大小分两档的是两款 Pro 型号,Gemini 3 Pro 预览版和 Gemini 2.5 Pro,分界线都是 20 万 token,输入价、输出价、上下文缓存价各有两个数。同一页上 Flash 系列的价格没有按提示大小分档。
过没过门槛只看输入。OpenClaw 估算费用的办法写在 token 用量文档里:一条请求按提示输入总量选档,总量等于未缓存输入加缓存读取加缓存写入,输出 token 不参与选档;选中那一档的单价用在这条请求的每一类 token 上,门槛以下的部分也按新价算。
同一场会话,门槛前一条请求和门槛后一条请求差多少钱
一条请求的费用拆成四项相加:
费用 = 未缓存输入 × 输入价 + 缓存读取 × 缓存读取价 + 缓存写入 × 缓存写入价 + 输出 × 输出价(数量以百万 token 计)
拿 GPT-6 Astra 算。假设会话里相邻的两条请求,前一条输入 270,000 token,后一条因为多了一段工具返回变成 275,000 token,输出都是 4,000 token,都没有命中缓存,缓存写入也先按 0 算:
- 门槛前:0.27 × $10 + 0.004 × $50 = $2.70 + $0.20 = $2.90
- 门槛后:0.275 × $20 + 0.004 × $75 = $5.50 + $0.30 = $5.80
输入只多了 5,000 token,这一条贵了 $2.90。
换成缓存工作正常的情况,两条请求里各有 260,000 token 命中缓存,剩下的 10,000 和 15,000 是新内容:
- 门槛前:0.26 × $1 + 0.01 × $10 + 0.004 × $50 = $0.26 + $0.10 + $0.20 = $0.56
- 门槛后:0.26 × $2 + 0.015 × $20 + 0.004 × $75 = $0.52 + $0.30 + $0.30 = $1.12
缓存把绝对数压低了,过门槛之后仍然是翻一倍。这两组都没计缓存写入。你的 cacheWrite 不是 0 的话,那部分门槛前按 $12.50、门槛后按 $25.00 另加。
会话不压缩的话输入只会继续涨,之后每条请求都在第二档。过了门槛之后要是又发出 20 条大小相近的请求,和停在门槛前的那种请求比,每条多 $0.56,20 条就是 $11.20。
这里的「一条请求」指的是一次模型调用,和你发的一条消息不是一回事。龙虾处理一条消息时每调一次工具,就要带着全部历史再请求一次模型。OpenClaw 文档写的是,一轮的合计等于其中每次模型请求各自算出的费用之和,工具循环和重试里的每一次都单独选档。
Gemini 3 Pro 预览版的分界线在 20 万,输入价、输出价、缓存价都按提示大小分两档,提示一过线三个价一起换。把两条请求换成 190,000 和 210,000 输入,输出还是 4,000。前一条:0.19 × 2.00 + 0.004 × 12.00 = 0.428 美元;后一条:0.21 × 4.00 + 0.004 × 18.00 = 0.912 美元。
提示缓存到底省多少,哪些情况开了反而多花
提示缓存做的事,是让厂商复用提示里没有变化的那段前缀,比如系统提示、工具定义和已经发生过的对话。这一段不再按全价输入收费,改按缓存读取价收。读取便宜,写入要另外付钱。
Anthropic 的定价页直接给了倍数:5 分钟缓存的写入是输入价的 1.25 倍,1 小时缓存的写入是 2 倍,命中读取是 0.1 倍,Claude Opus 5.5 的读取是 0.05 倍,Claude Fable 5.1 是 0.025 倍。拿 Claude Sonnet 5.5 算一笔。假设一段 100,000 token 的固定前缀,在缓存有效期内连续用了 10 次,只算这段前缀的钱:
- 不开缓存:10 × 0.1 × $2 = $2.00
- 5 分钟缓存:写入 0.1 × $2.50 = $0.25,9 次读取 9 × 0.1 × $0.20 = $0.18,合计 $0.43
- 1 小时缓存:写入 0.1 × $4 = $0.40,9 次读取 $0.18,合计 $0.58
多花出现在写了没人读的时候。还是这 10 次请求,要是每两次之间都隔了 5 分钟以上,缓存每次都已过期,10 次全是写入:10 × 0.1 × $2.50 = $2.50,比不开缓存的 $2.00 多 $0.50。同样的间隔换成 1 小时缓存,只要相邻两次之间都不到 1 小时,缓存一直有效,还是上面的 $0.58。Anthropic 定价页给的回本点是:5 分钟缓存读到 1 次就回本,1 小时缓存要读到 2 次。
OpenAI 这边,GPT-6 Astra 的模型页写着缓存写入按未缓存输入价的 1.25 倍计,也就是 $12.50;缓存读取 $1.00,是输入价的十分之一。
Gemini 的缓存多一项按时间收的存储费。以 Gemini 3 Pro 预览版为例,缓存 100,000 token、存满 1 小时的话:存储费 0.1 × 4.50 = 0.45 美元;每命中一次省 0.1 × (2.00 − 0.20)= 0.18 美元(提示在 20 万以内那档);0.45 ÷ 0.18 = 2.5,一小时内至少命中 3 次才盖得住存储费。
在龙虾里,缓存时长由 cacheRetention 控制,取值是 none、short、long,可以设成全局默认,也可以按型号、按 agent 单独设。提示缓存文档里各家的对应关系是:
- 直连 Anthropic:
short是 5 分钟缓存,long是 1 小时缓存;没设的时候 OpenClaw 默认按short。 - 直连 OpenAI:缓存是自动的;对 GPT-5.6 及之后的型号,
long会请求 30 分钟的缓存时长。 - 直连 Gemini:给
gemini-2.5、gemini-3开头的型号设了cacheRetention之后,OpenClaw 自动创建和续用缓存资源,short是 300 秒,long是 3600 秒。
写法如下,示例里的 long 换成你按上面对应关系选的值:
agents:
  defaults:
    params:
      cacheRetention: "long" # none | short | long
会话中途换模型、改思考等级,下一条请求可能就读不到缓存。同一份文档写着,换模型一定会开始一套新的缓存,改思考或推理等级也可能让缓存失效。在意缓存的,建会话时把模型和思考等级定好,中途要换就另开一个会话。
会话隔一阵才用一次的,文档给了一套省钱优先的起步配置:cacheRetention 设成 short,再把 agents.defaults.contextPruning.mode 设成 cache-ttl,让缓存过期后的下一条请求先剪掉旧的工具结果,不必把整段膨胀的历史重新写进缓存。
在龙虾里怎么看一次会话用了多少 token,怎么让会话别冲过门槛
查用量的命令都在聊天里发:
/status:当前会话的模型、上下文用量、上一次回复的输入 / 输出 token,以及费用。/usage tokens:每条回复末尾附上这一轮的 token 和缓存明细。/usage full换成带模型、上下文和费用的紧凑版,/usage off关掉。/usage cost:按 OpenClaw 会话日志汇总的本地费用小结。/context list和/context detail:看系统提示、工具、技能和每个注入文件各占多少。
命令行的 openclaw status --usage 显示的是各家的额度窗口还剩百分之几,不含每条回复的费用,查这类账单问题用不上它。
让会话变短靠压缩。按压缩文档,OpenClaw 会把较早的对话概括成一条摘要,最近的消息原样保留,完整历史仍然留在磁盘上,变的只是模型下一轮看到的内容。自动压缩默认开着,触发条件是会话接近上下文上限,或者模型返回了上下文溢出的错误。
这两个触发条件都跟着上下文上限走,文档列的条件里没有「接近加价门槛」这一项。对直连 OpenAI 的 GPT-5.5 和 GPT-5.6,上下文上限和加价门槛这两个数默认是同一个:token 用量文档写着,这些型号公布的总窗口是 1,050,000 token,OpenClaw 默认只给 272,000 的运行预算,922,000 的输入预算要自己选择开启,开了之后输入一过 272,000 就是整条请求的长上下文价。文档举的例子是 GPT-5.5 和 GPT-5.6。用 Astra 的发一次 /usage full,页脚有数据时会带上下文窗口,写成 272k 这样的数;看完再发 /usage tokens 切回缓存明细。你用的型号要是窗口比加价门槛大,就得自己在门槛前动手:/status 里的上下文用量接近门槛时,手动压一次。
/compact
/compact Focus on the API design decisions
第二种写法是在命令后面跟一句说明,告诉摘要该保留什么。手动压缩保留最近多少内容,由 agents.defaults.compaction.keepRecentTokens 决定,默认 20,000。压完再发一次 /status,上下文用量应该降下来;卡片上还有一行 Compactions,记的是这个会话压缩过几次。手头的任务已经告一段落的,/new 直接开一个新会话,不做压缩。
压缩自己也花钱。生成摘要要调用模型,默认用的就是当前会话的模型。嫌贵可以把 agents.defaults.compaction.model 指到一款便宜的型号上,值的写法是 provider/model-id。压缩还会改写历史,缓存前缀跟着变,我建议估账时把压缩后的第一条请求当作没有命中缓存来算。
输入涨得慢一些,冲到门槛的时间就往后推。token 用量文档列了几条减压办法,和工具型任务关系大的有:
- 在自己的工作流里裁掉大段的工具输出。
- 截图多的会话,把
agents.defaults.imageMaxDimensionPx调低,默认值是 1200。 - 技能描述写短,技能列表每次都会注入系统提示。
常见问题
- 已经命中缓存的那部分输入,算不算进 272K 的门槛?
- 算。OpenClaw 估算费用时,一条请求选哪一档看的是提示输入总量,等于未缓存输入加缓存读取加缓存写入,输出 token 不参与。GPT-6 Astra 模型页的规则是输入超过 272K token 的提示整条请求加价,缓存费率同样乘 2,没有把命中缓存的部分排除在外,缓存读取从每 100 万 token 1.00 美元变成 2.00 美元。
- /status 显示的费用和厂商后台的账单对不上,以哪个为准?
- 以厂商账单为准。按 OpenClaw 文档,它显示的费用来自记录下来的金额,或者用量数据乘以本地价格表得出的估算;价格表是配置里 models.providers 下各型号的 cost 字段,单位是每 100 万 token 的美元价,分 input、output、cacheRead、cacheWrite 四项,没写的沿用 OpenClaw 自带型号目录里的价格。Control UI 的 Usage 页的合计反映的是本机保存的会话历史,文档说明它不是厂商发票。
- 把 cacheRetention 设成 none,OpenAI 的提示缓存就关掉了吗?
- 没有关掉。按 OpenClaw 提示缓存文档,对直连 OpenAI 的型号,none 只是不再发送缓存键和缓存时长字段,OpenAI 那边的自动提示缓存照常生效。对 Anthropic 的型号,none 用来避免缓存写入,文档举的用法是给零星发通知的 agent 单独设成 none。